Trabalho / PriceTrail
Projeto pessoal · público · começado em outubro de 2026
Um monitor de preços que coleta, guarda e avisa sozinho, todo dia.
O PriceTrail acompanha preços de jogos e hardware em lojas do Brasil e dos EUA. É a versão pública da extração de dados gerenciada que faço para clientes: fontes que mudam, um coletor que sobrevive a elas e uma API em cima.
- Papel
- Design, backend, frontend, operação
- Stack
- Python · PostgreSQL · Next.js · GitHub Actions
- Status
- Em andamento · open source em breve
- Links
- Site e código-fonte chegam com o primeiro deploy
- 23:19:49steam-br · 10 offers · ok · 0.3s
A interface
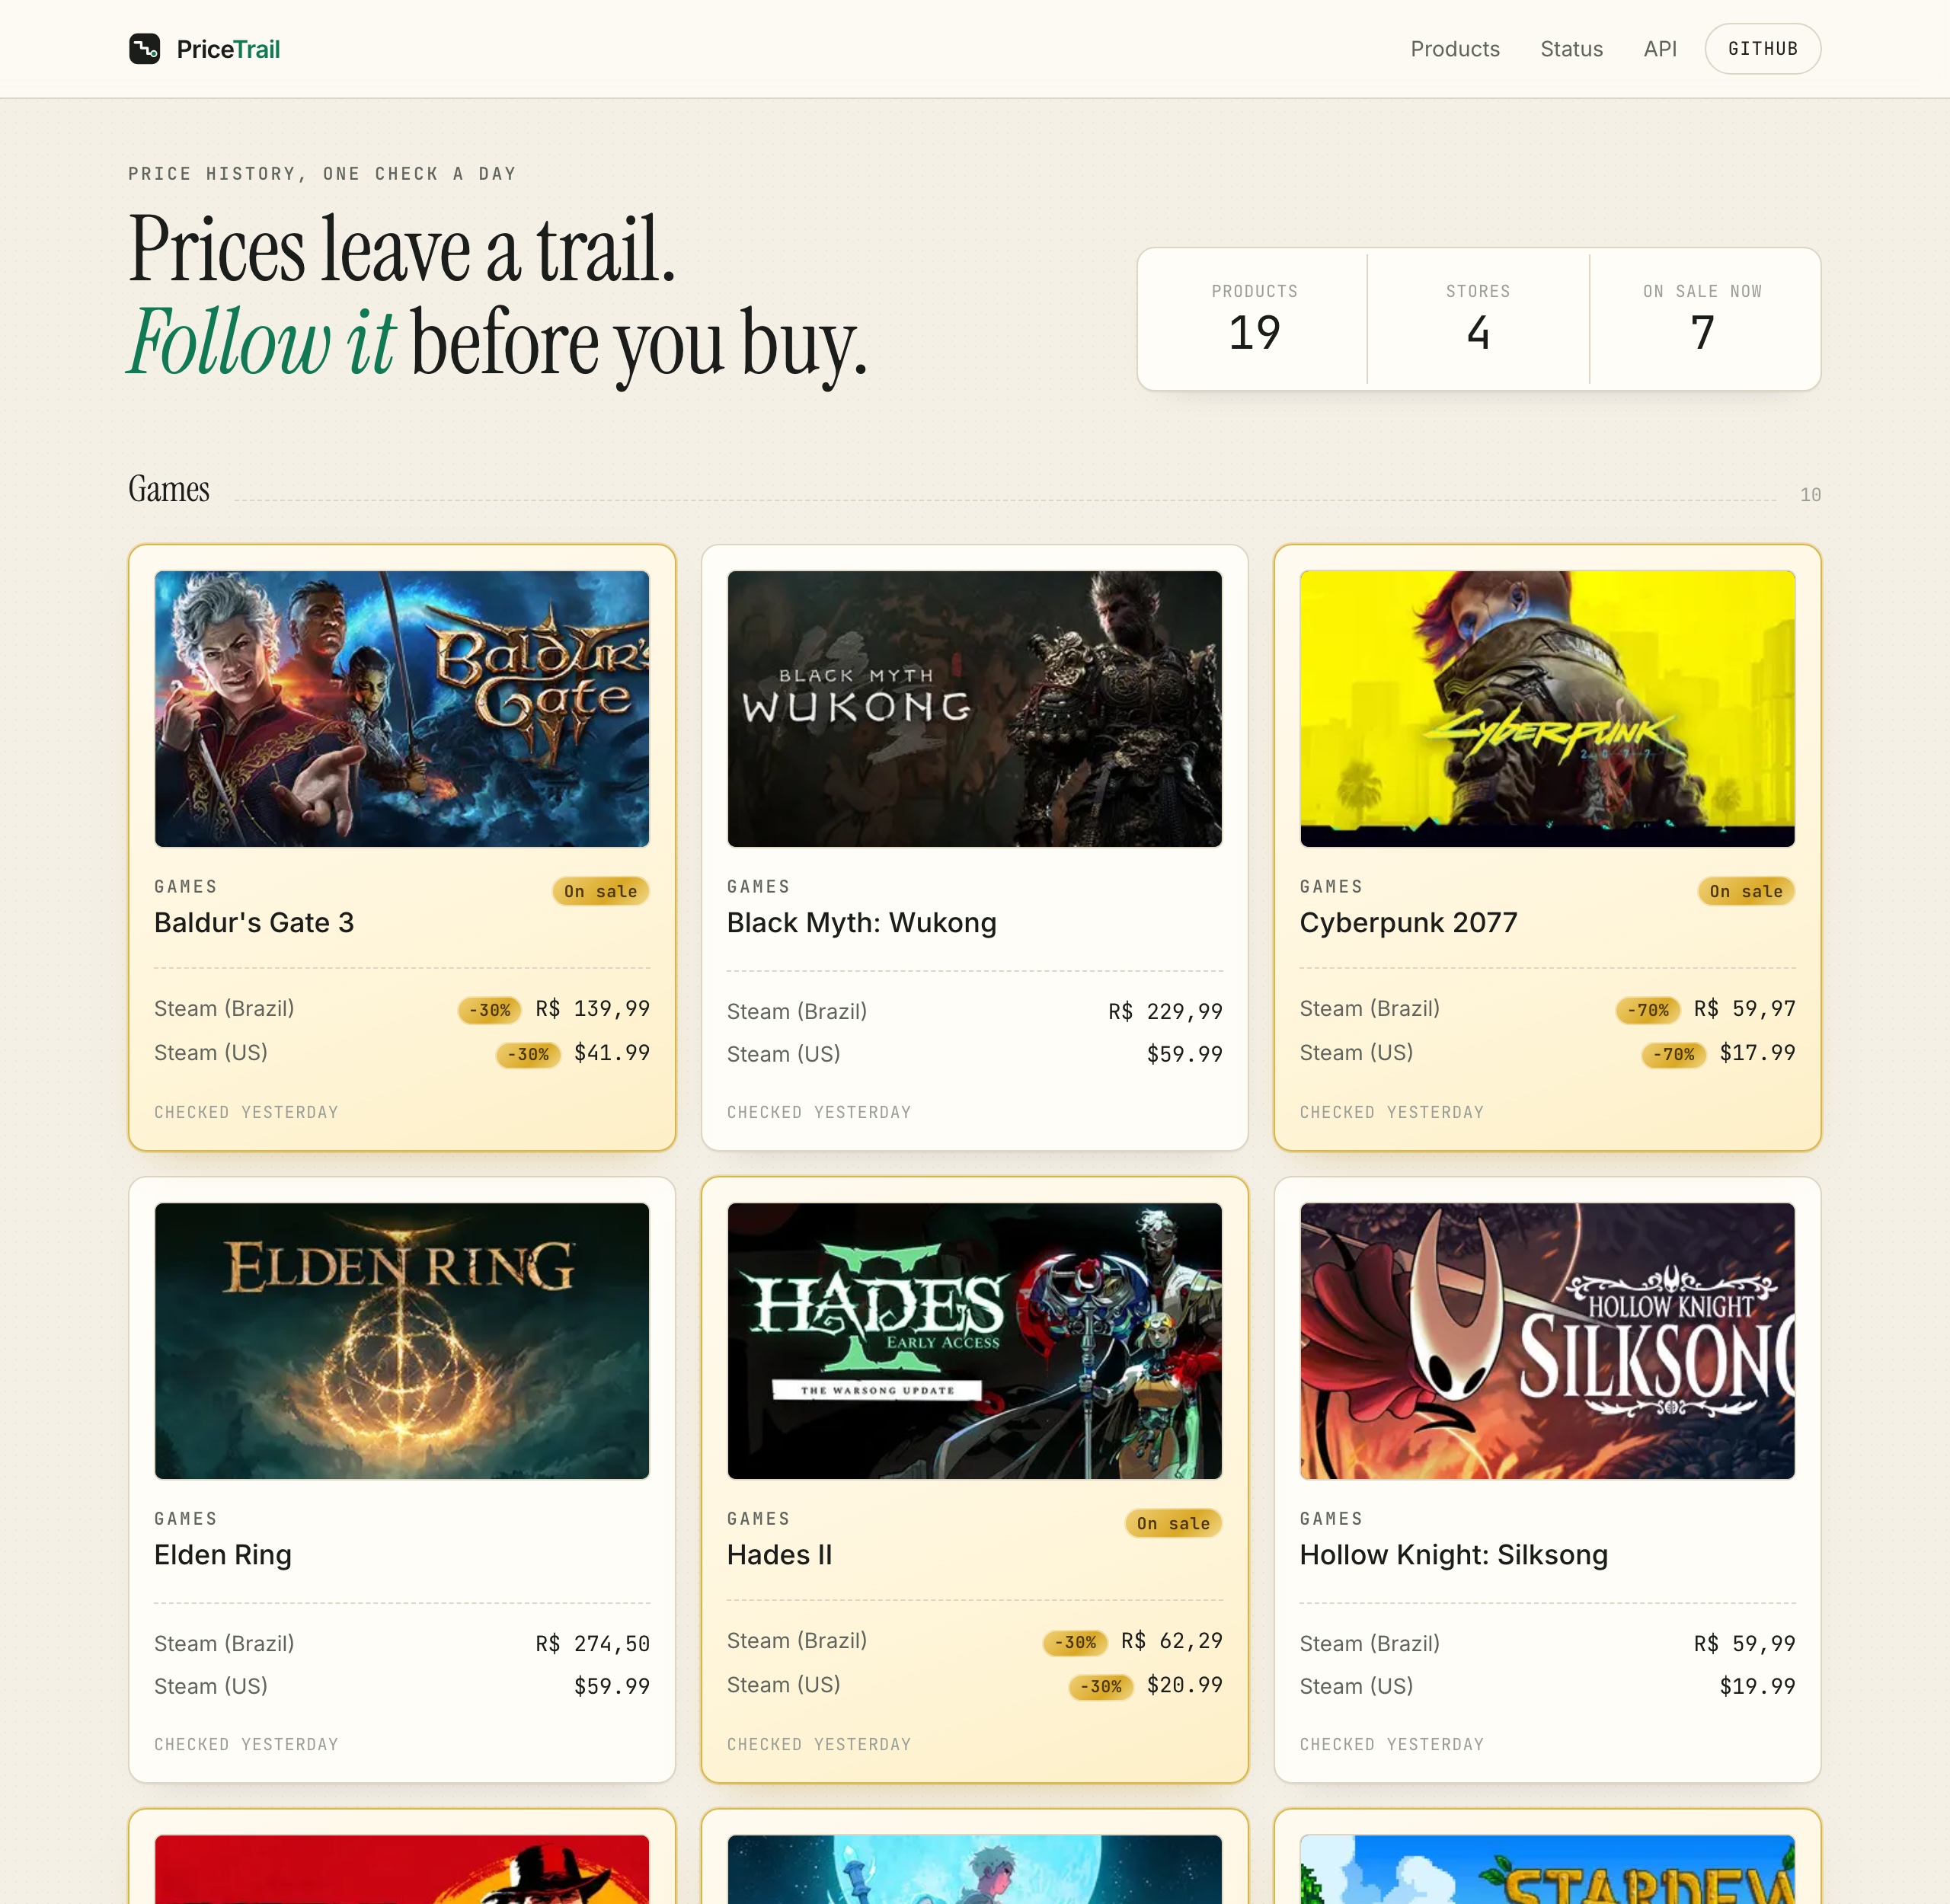
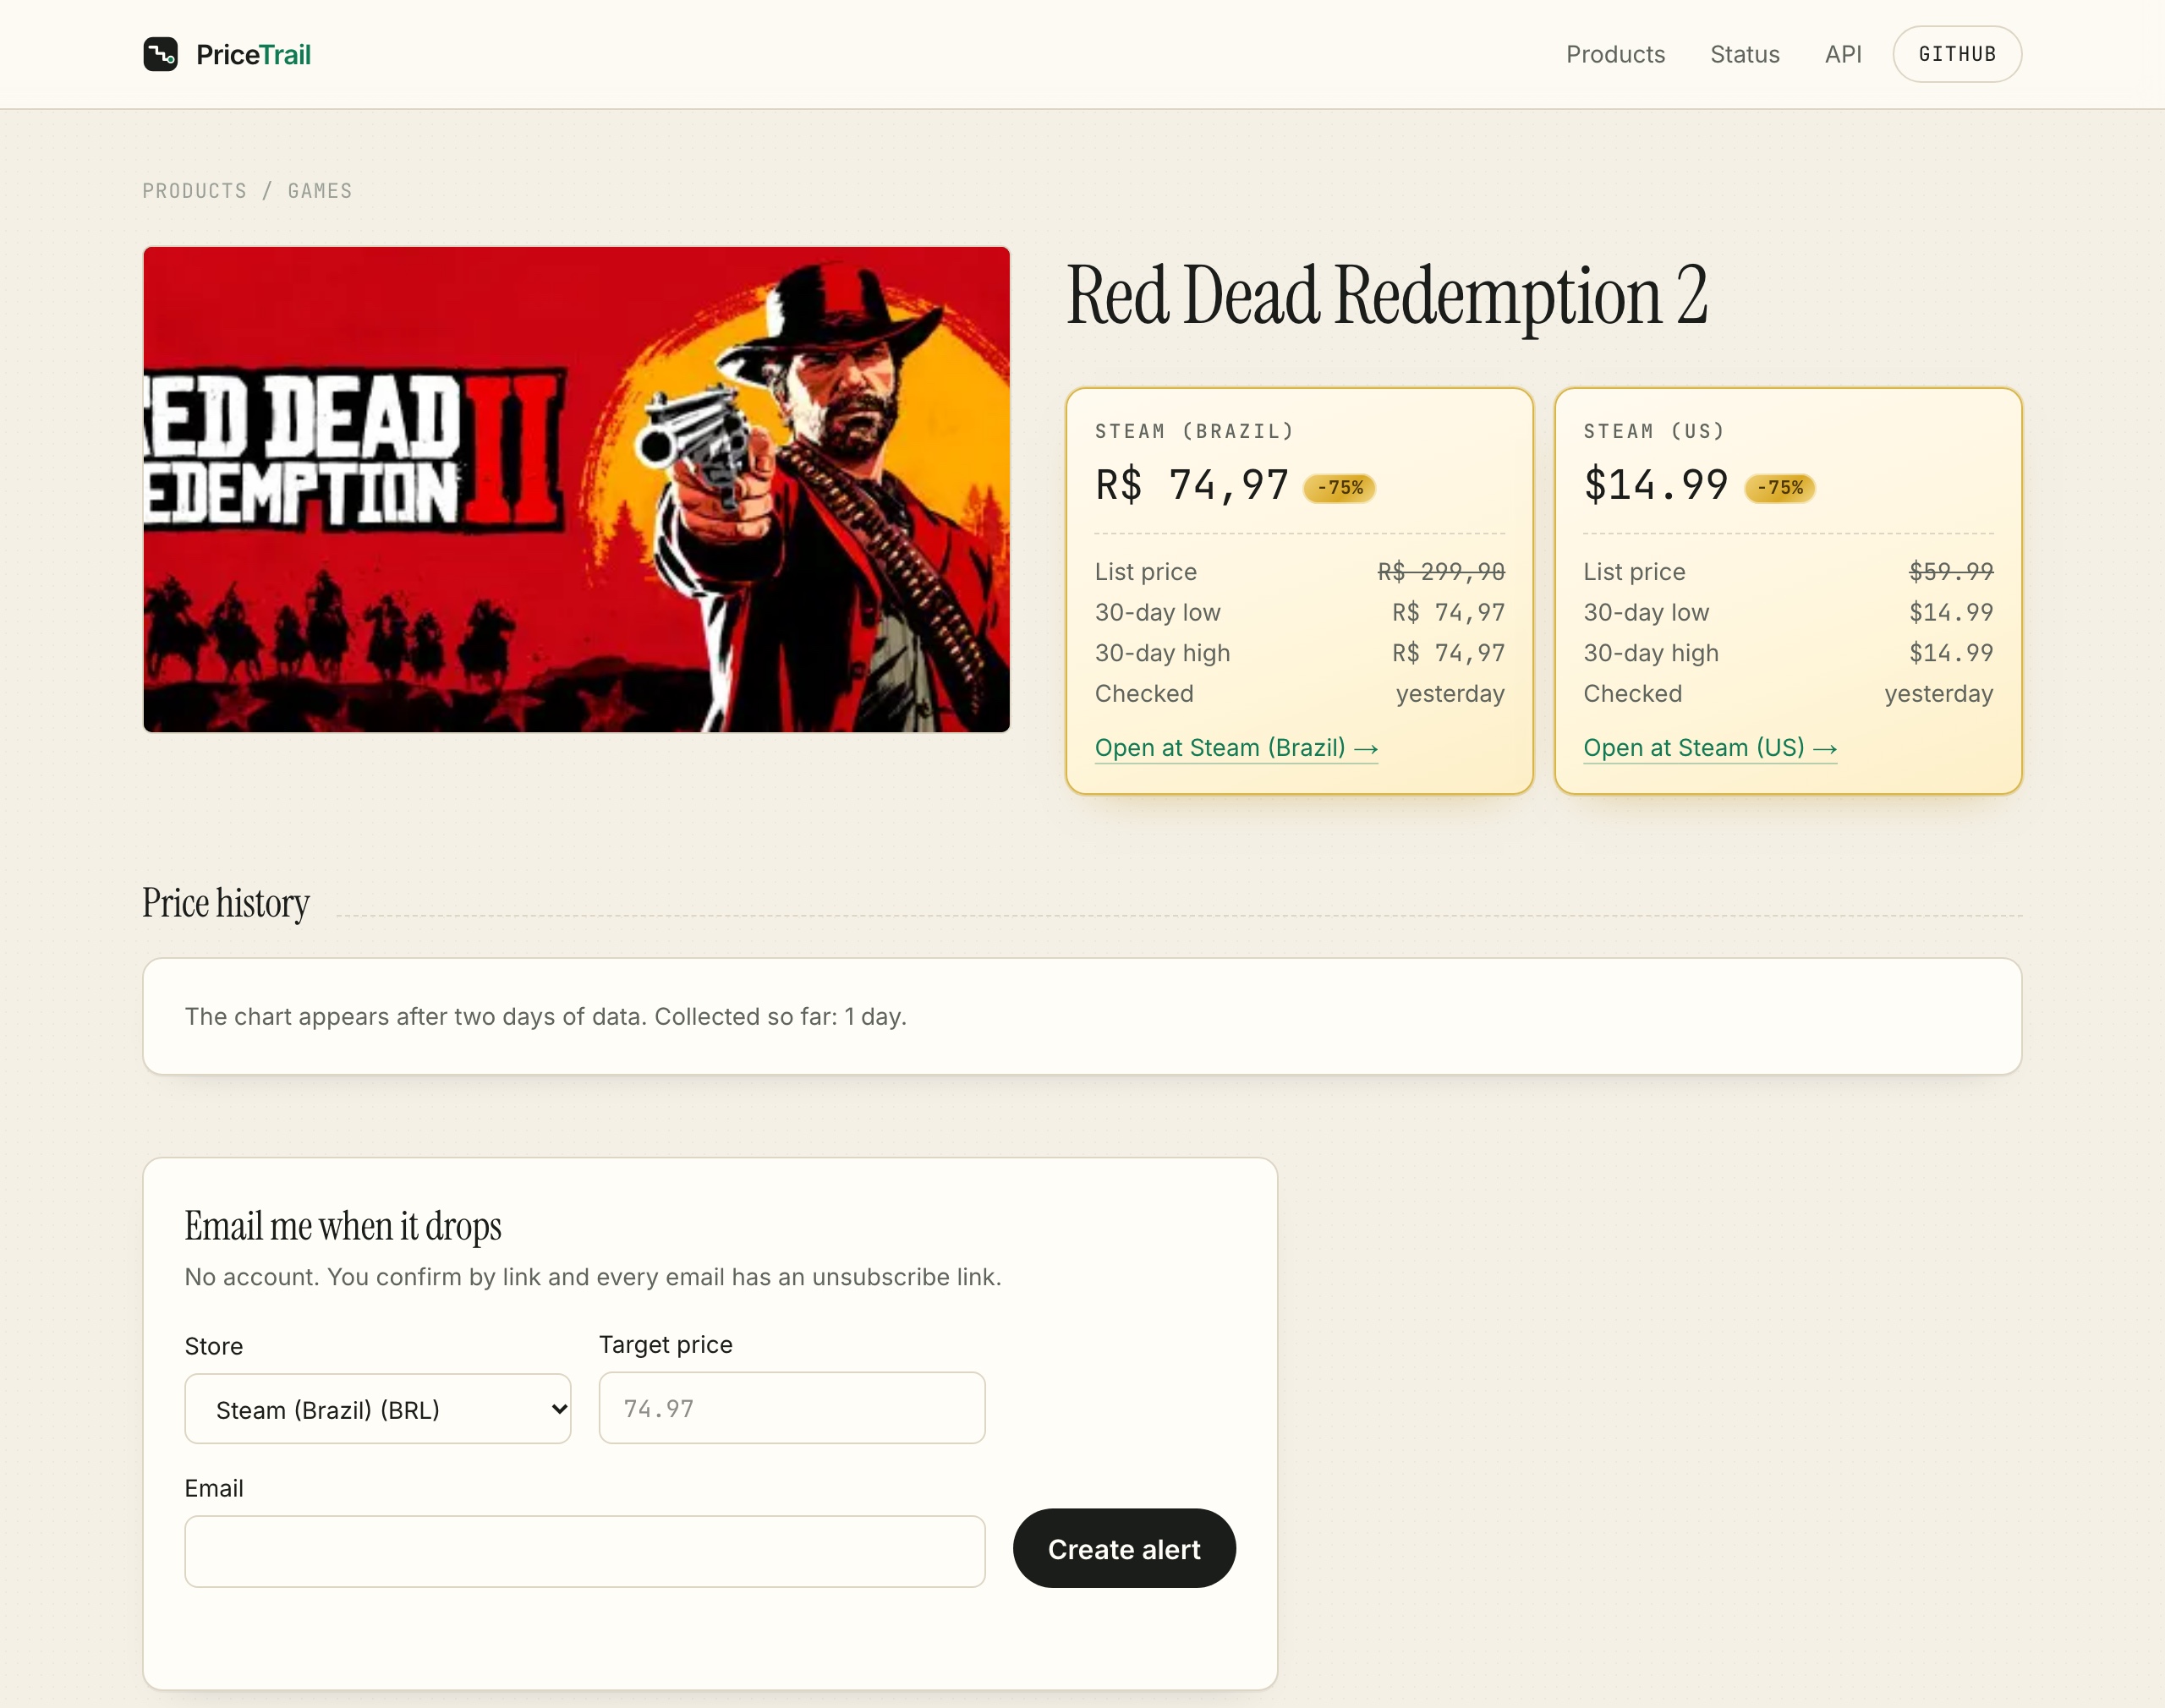
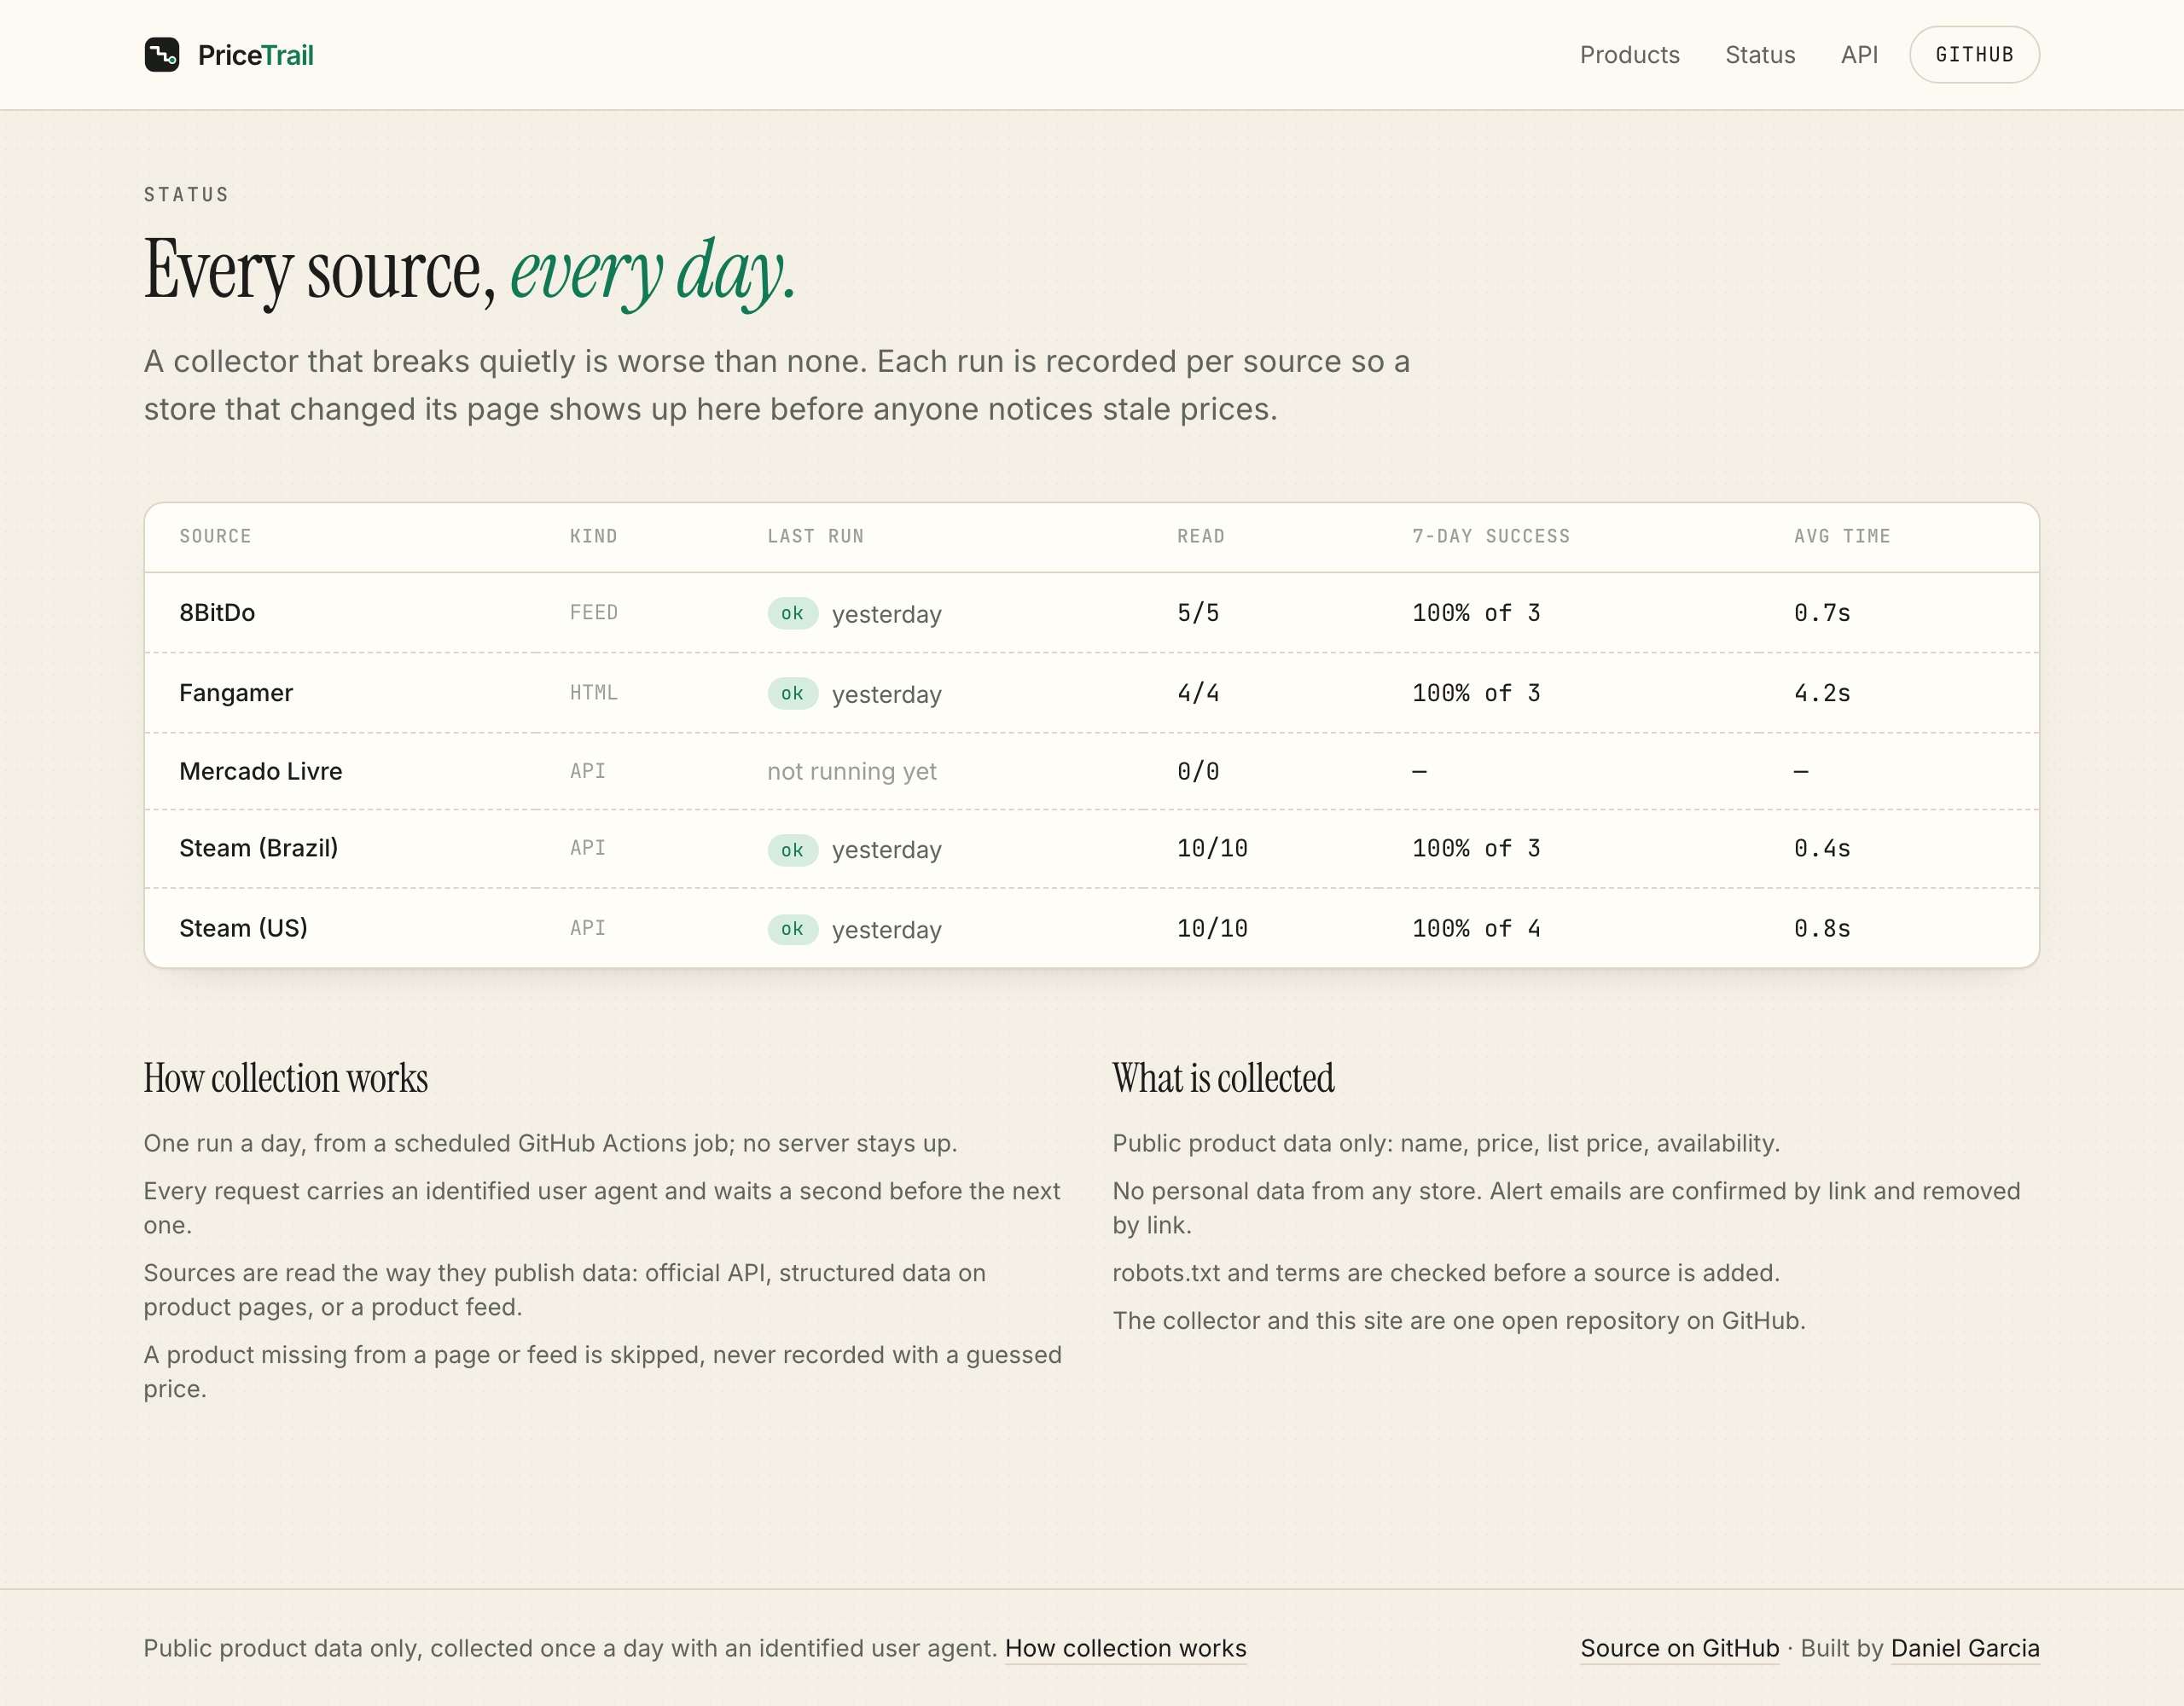
Um catálogo, uma página por produto e uma página de status que admite quando algo quebrou.
Papel quente, uma serifa e uma fonte mono, de propósito nada parecido com este site. Cada card mostra o último preço por loja, o preço de lista quando a loja publicou um, e quando foi a última checagem.
O que faz
Pequeno de propósito. Cada peça justifica o lugar.
- Histórico diário de preços
- Uma observação por oferta por dia, guardada para sempre, com a mínima e a máxima de 30 dias em cada produto.
- Dois tipos de selo
- “On sale” quando a própria loja publicou um preço de lista; “↓ −x%” quando o preço caiu abaixo da última observação diferente. Os dois podem aparecer juntos.
- Alertas de preço por e-mail
- Escolha a loja e o preço-alvo. Você confirma por link, todo e-mail tem link de descadastro, e não existe conta.
- Página de status
- Cada execução fica registrada por fonte: status, ofertas lidas, duração, erro. Uma loja que mudou a página aparece antes de alguém ver um preço velho.
- API JSON somente leitura
- /api/products, /api/products/{slug} e /api/status. Sem chave; com cache, atualizada depois de cada execução.
- Duas moedas, dois países
- Steam no Brasil e nos EUA lado a lado, então o mesmo jogo aparece em BRL e em USD.
Como os dados são coletados
Ler cada loja do jeito que ela publica, nunca chutar.
Não existe um scraper genérico. Cada fonte é um adaptador pequeno com um método, fetch(offers), e um parser mantido como função pura para poder ser testado offline contra respostas salvas. Quatro tipos até agora:
As regras que ele segue
- Só dados públicos de produto: nome, preço, preço de lista, disponibilidade. Nenhum dado pessoal de loja nenhuma.
- robots.txt e termos são checados antes de adicionar uma fonte; as duas lojas Shopify declaram que as páginas de produto podem ser rastreadas.
- User-Agent identificado, uma requisição por segundo, no máximo uma execução por dia.
- Um produto que some de uma página ou feed é pulado e a execução vira “partial”; um preço nunca é chutado nem gravado como “indisponível”.
- Falhas recuam exponencialmente. Uma fonte que continua falhando é pulada no dia, nunca tentada em loop.
JSON público da loja
Steam (Brasil, EUA)
O endpoint de preços da própria loja, em lote onde ela permite, uma requisição por região.
Páginas de produto · schema.org
Fangamer
Lê as ofertas do Product em JSON-LD ou microdata, então o mesmo adaptador funciona em qualquer loja que publique dados estruturados.
Feed Atom de produtos
8BitDo
O feed no estilo Shopify que muitas lojas expõem em /collections/all.atom: uma requisição para o catálogo inteiro.
API oficial
Mercado Livre
App com client credentials registrado no marketplace; a fonte é pulada enquanto as chaves não existem, nunca raspada.
Como roda
Nenhum servidor para manter de pé.
Um cron do GitHub Actions roda migrate → seed → collect → notify → revalidate. O catálogo vive num arquivo TOML e é semeado no Postgres; o coletor grava um ponto de preço por oferta e uma linha por execução; os alertas saem depois da execução; o site derruba o cache por último, então nunca mostra um dia pela metade.
A API
Tudo que o site mostra, você também consegue buscar.
Produtos, ofertas, mínimas de 30 dias e o status de cada fonte são JSON somente leitura, atualizado logo depois de cada coleta diária. É o mesmo formato que entrego para clientes: estável e documentado.
$ Por baixo do capô
Escolhas sem graça, para continuar rodando.
- Schema
- Seis tabelas em SQL puro (products, offers, price_points, runs, sources, alerts), migrações aplicadas em ordem pelo CLI, e uma view source_status que alimenta a página de status e o pricetrail status.
- Testes
- pytest: os parsers rodam contra fixtures salvas de cada loja; os testes do coletor e dos alertas usam o banco real em schemas descartáveis.
- CI
- Todo push roda pytest e ruff no coletor, tsc e eslint no site.
- Site
- Next.js 16 com componentes em cache marcados “prices”; o coletor chama /api/revalidate com um segredo depois de cada execução. O gráfico de preços é um SVG renderizado no servidor, um painel por moeda.
- CLI
- pricetrail migrate · seed · collect · notify · status, os mesmos comandos que o cron roda.
Os números são um retrato do banco do próprio projeto em 2026-10-06.
Os seus dados
Precisa de algo assim para os seus preços, anúncios ou dados de catálogo?
Se está público em outros sites, consigo coletar todo dia, manter limpo e entregar como uma API ou uma página que o seu time usa.